Mode Research, développer un indicateur et mesurer ses signaux
Le mode Research permet de tester une idée d'entrée avant d'en faire une stratégie. L'utilisateur écrit son indicateur en quelques lignes ; le mode mesure ce qui se passe réellement après chaque signal, le compare à des entrées tirées au hasard et à la version précédente, puis affiche le résultat sur un graphique relié au notebook.
À ce stade, aucune gestion de trade, aucun frais et aucune compilation ne sont nécessaires. L'objectif est de savoir rapidement si le signal mérite d'être développé dans le mode Algo.
0compilation pour tester une nouvelle variante
2comparaisons automatiques à chaque run : version précédente et référence
25mesures par horizon et par sens, face au hasard
4phases pour entraîner l'œil à l'aveugle
Aperçu
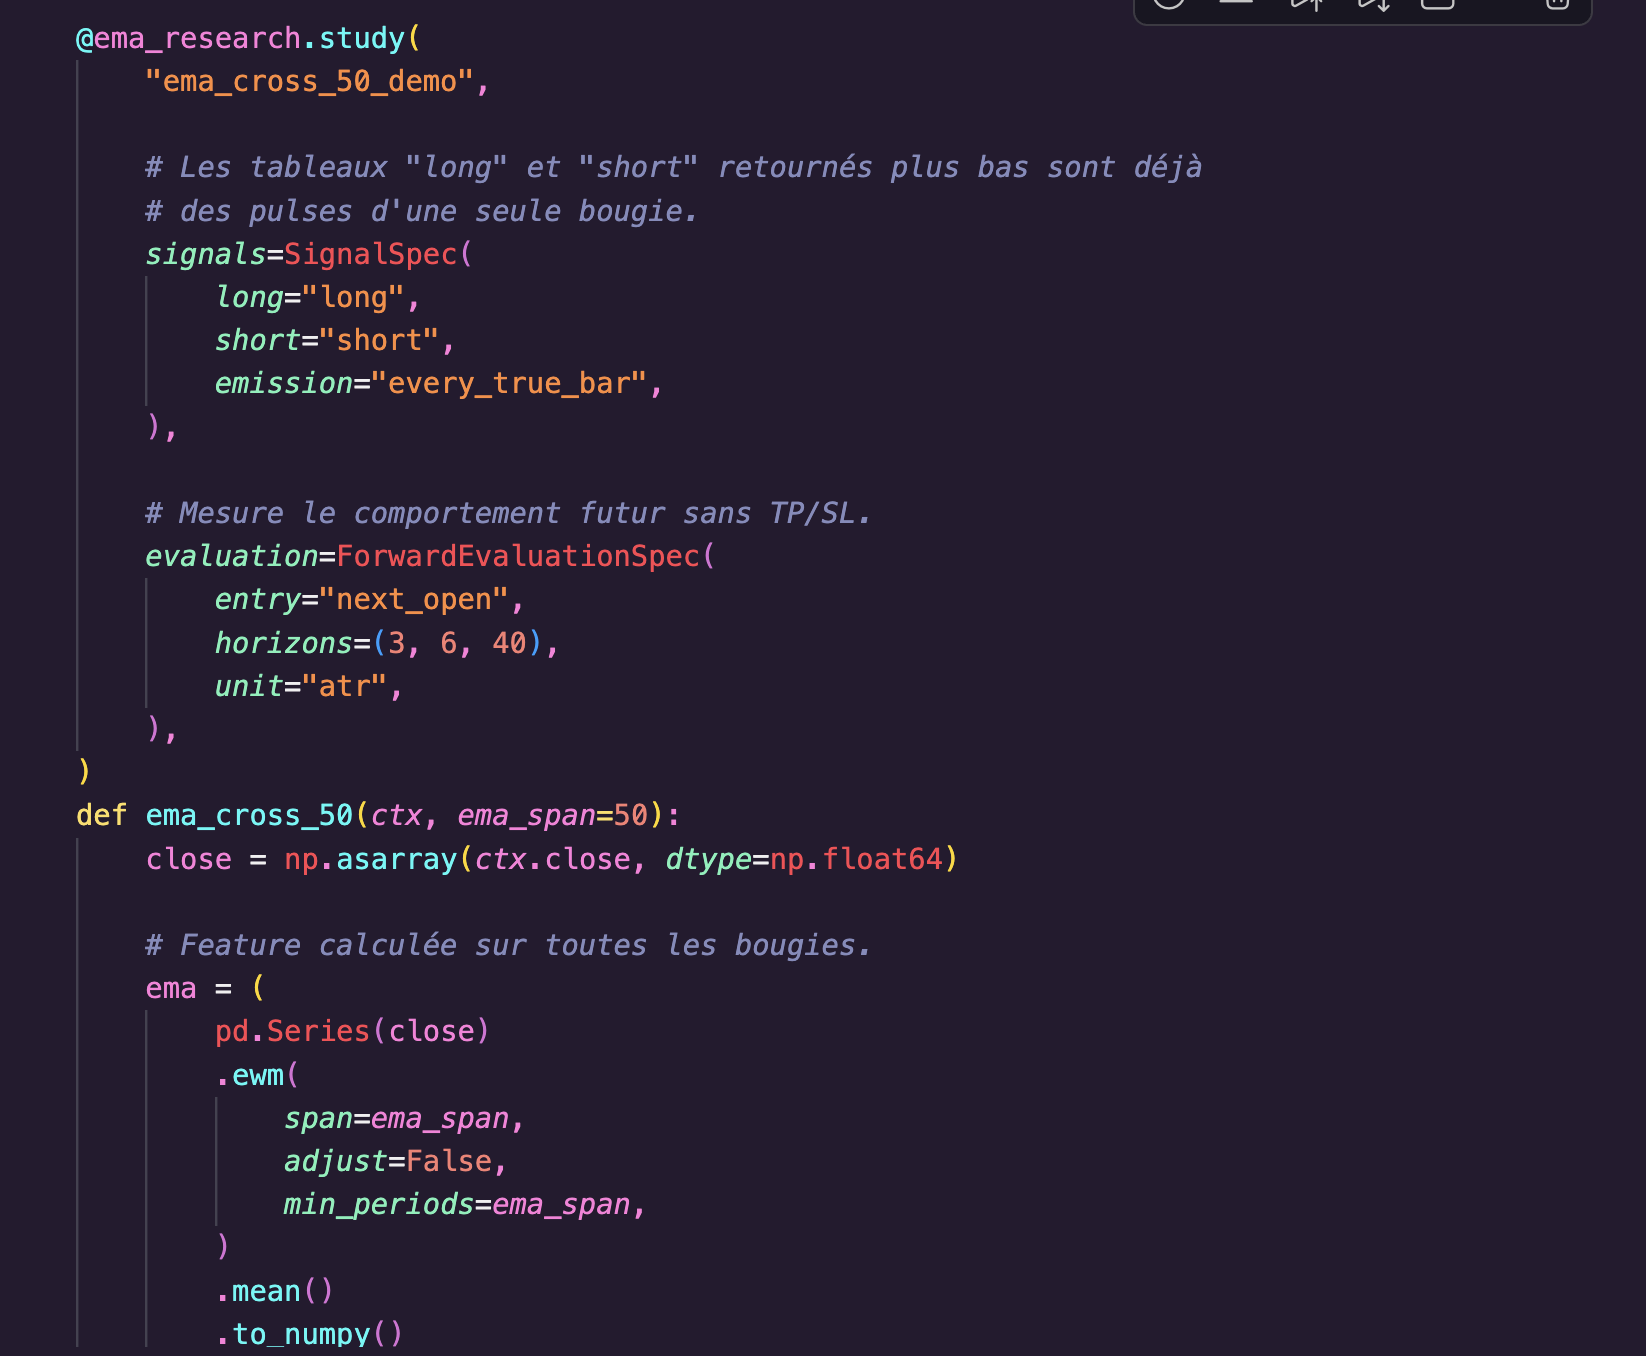
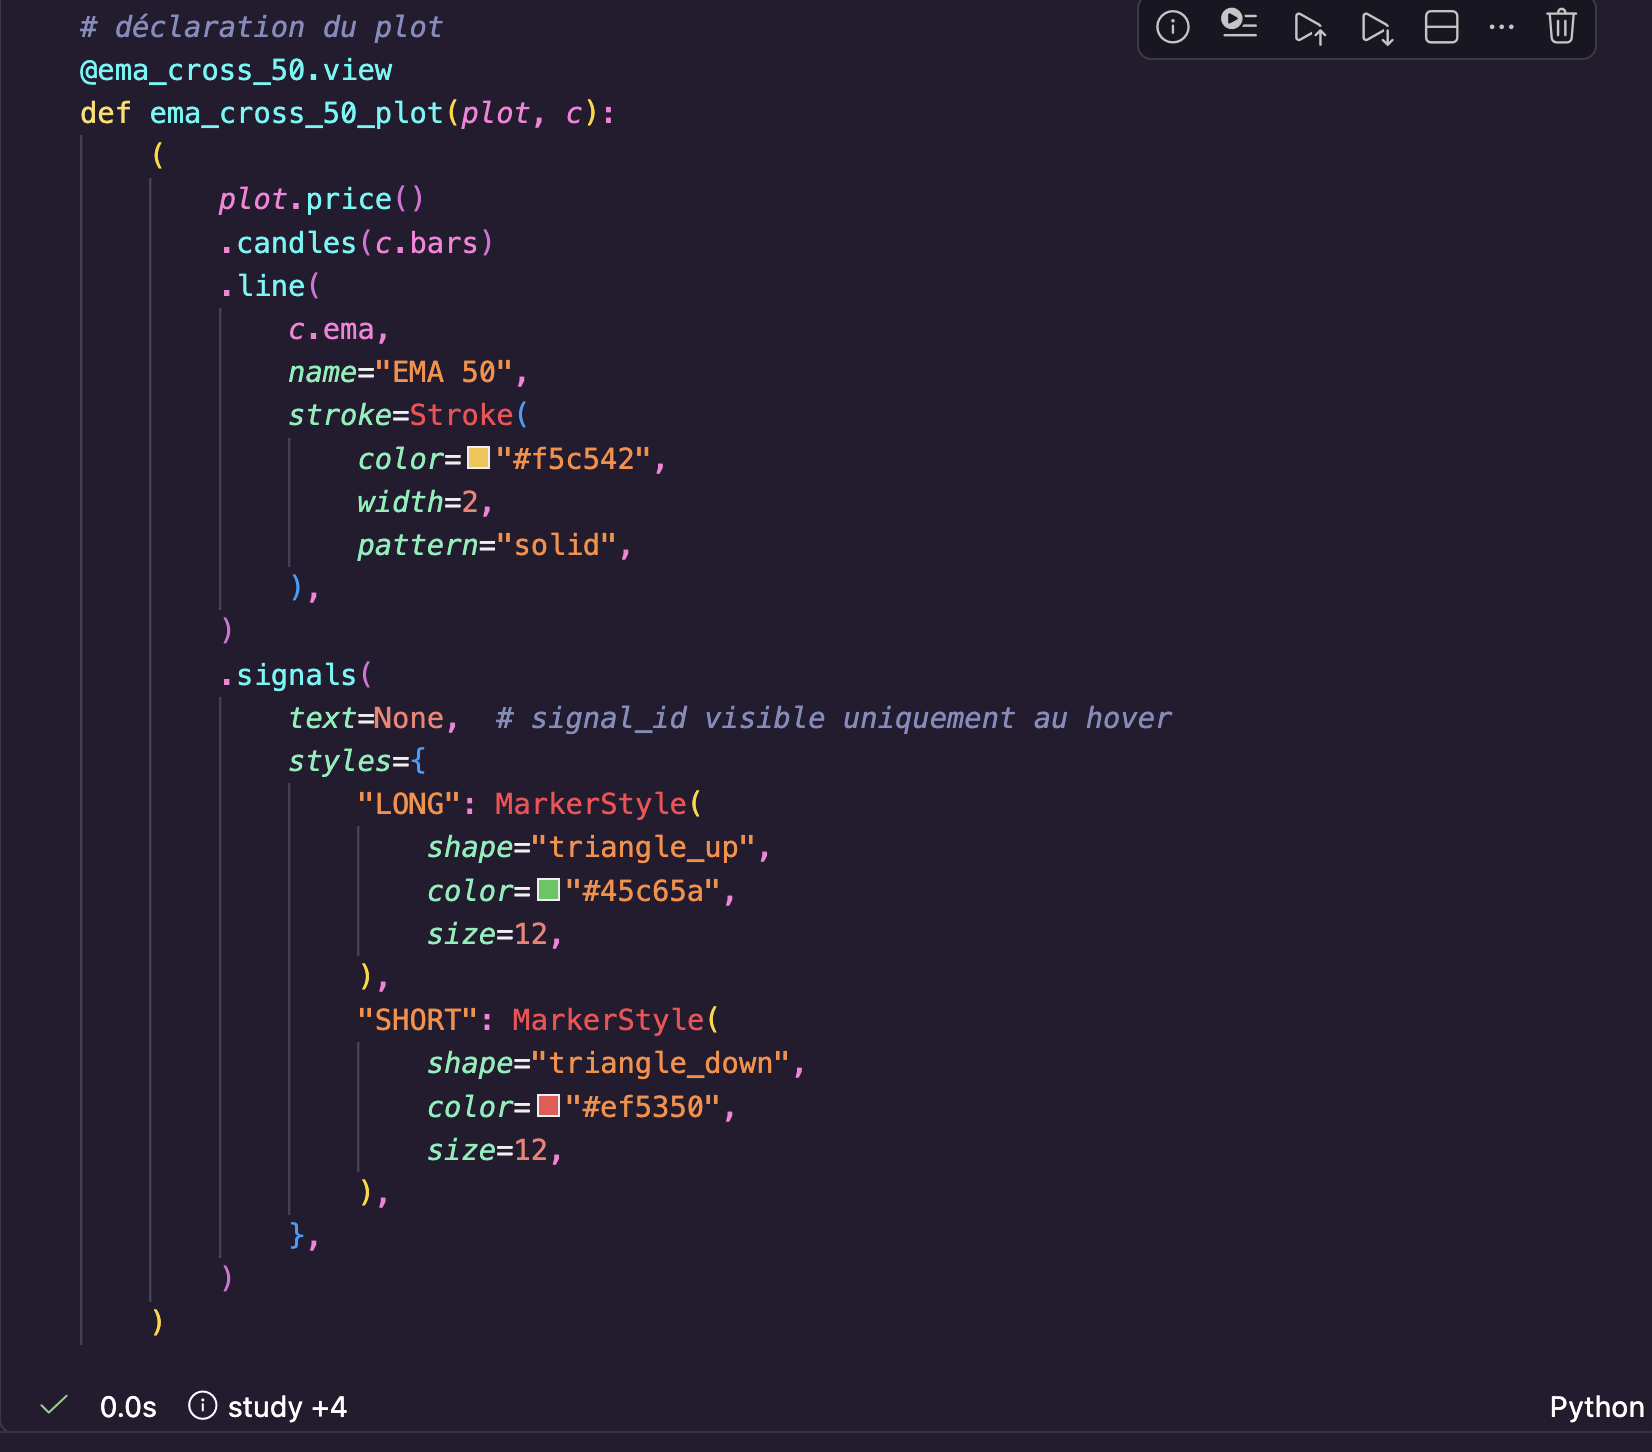
L'étude. À gauche, une EMA 50 : ses signaux et ce que l'on mesure ensuite (horizons de 3, 6 et 40 barres, en unités ATR). À droite, la déclaration du graphique. Cliquez sur une capture pour l'agrandir.
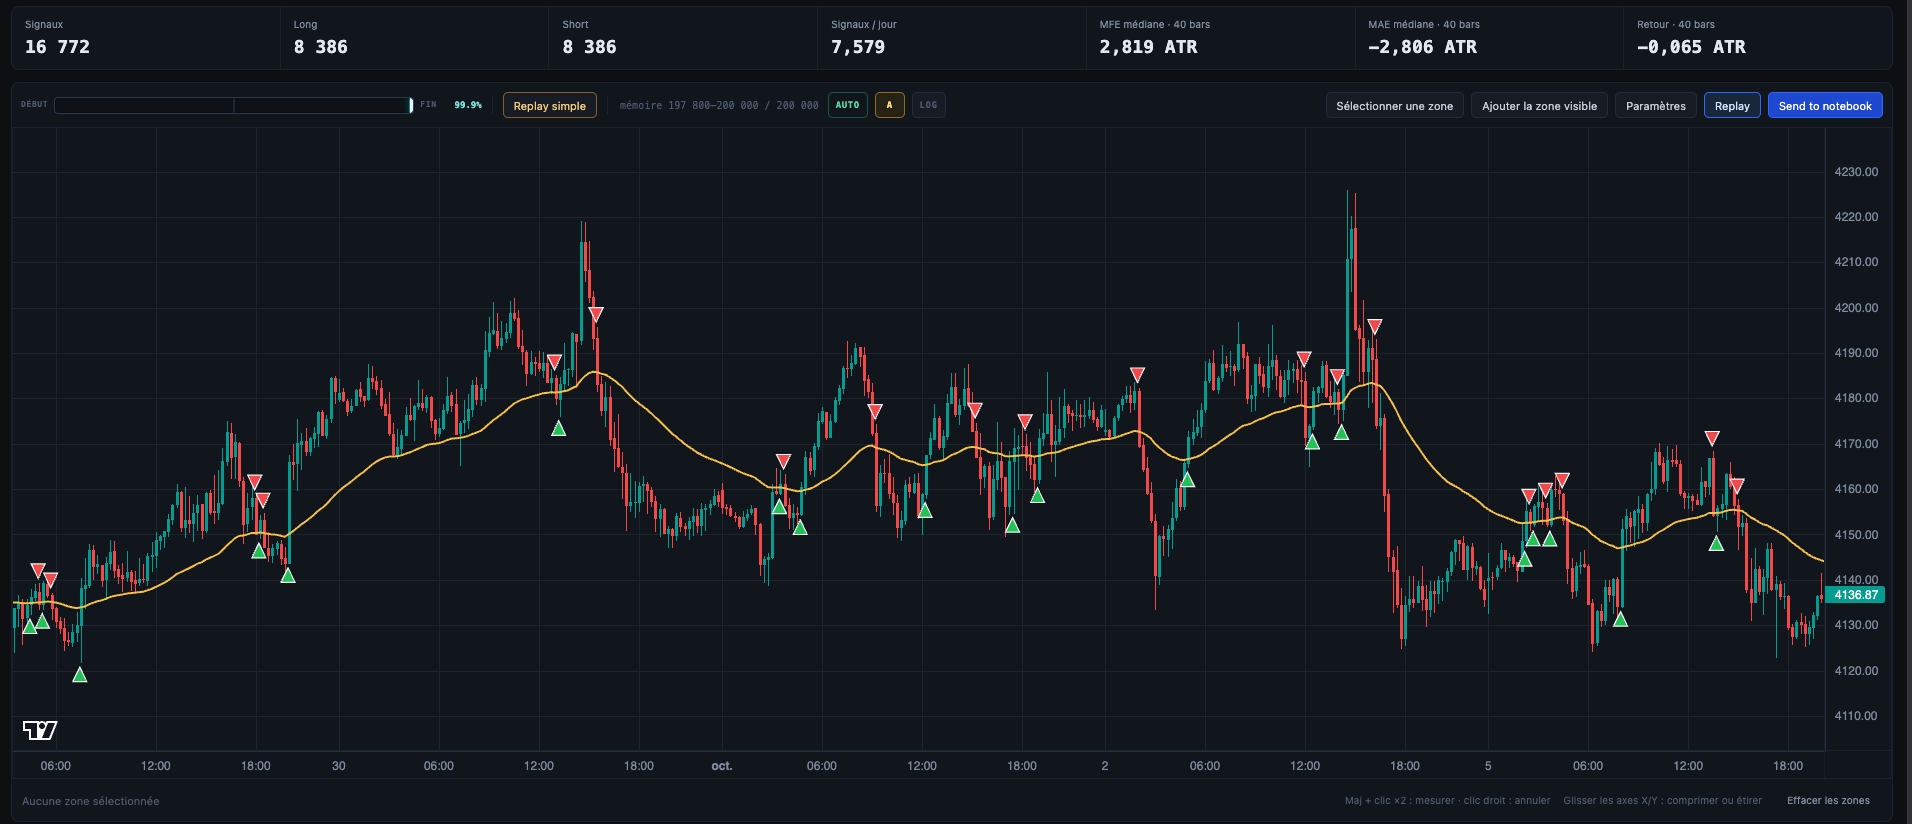
Le graphique. Le résultat de cette étude dans le serveur local : signaux long et short sur l'or, EMA 50, et en haut les mesures du rapport (MFE, MAE et retour médians à 40 barres, en ATR).
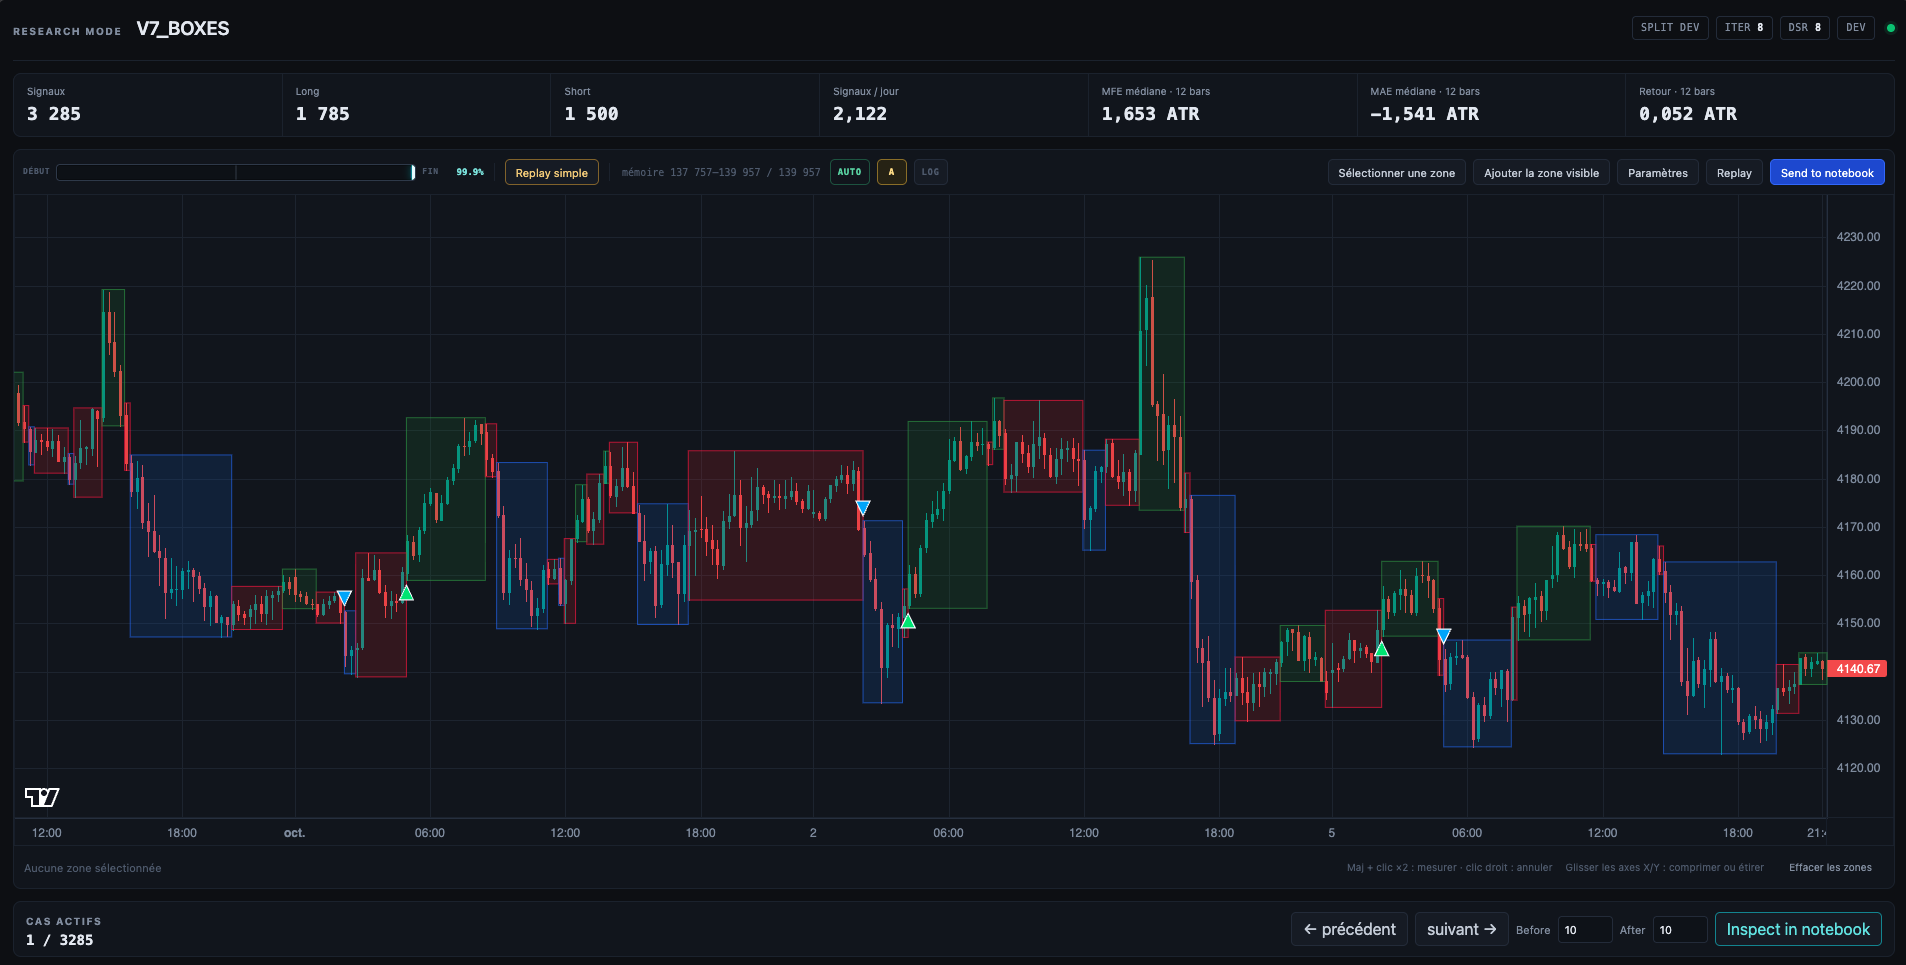
Les cas. Sur une autre étude en développement, chaque signal se parcourt un par un et s'ouvre dans le notebook. En haut à droite, ITER et DSR indiquent le nombre d'essais déjà comptés.
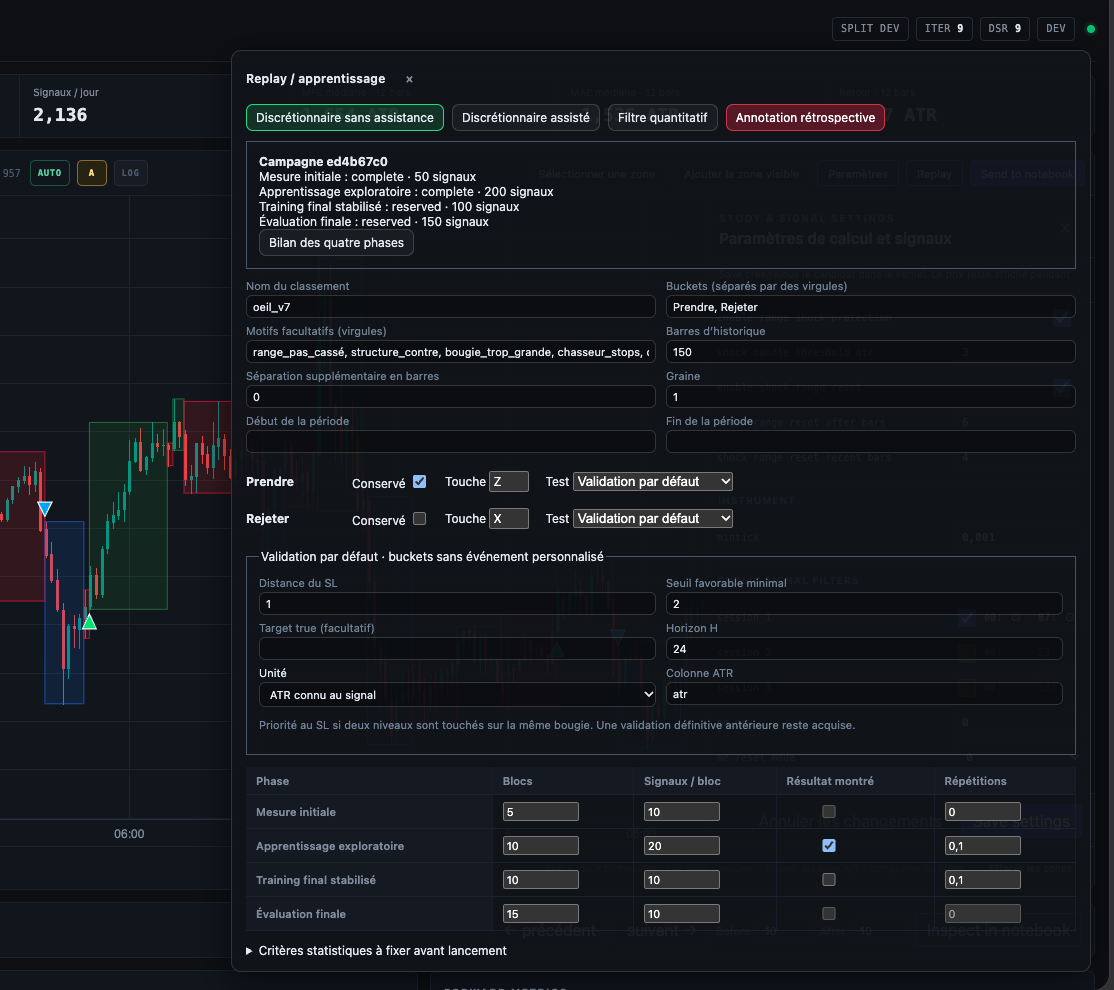
L'entraînement. Paramétrage d'une campagne de replay à l'aveugle : quatre phases, des fenêtres réservées et des critères fixés avant le lancement.
01Écrire une étude
Déclarer un indicateur, ses signaux et ce que l'on veut mesurer
Une étude est une fonction Python qui reçoit les prix, calcule ses colonnes et renvoie des signaux long et short. Trois déclarations l'accompagnent, afin que chaque choix reste explicite :
SignalSpec indique comment un signal devient un événement : à la première bougie d'une séquence (rising_edge) ou à chaque bougie (every_true_bar), avec un cooldown éventuel ;
ForwardEvaluationSpec fixe ce que l'on mesure ensuite : point d'entrée, horizons et unité ;
la vue choisit les courbes, les marqueurs et les panneaux affichés sur le graphique.
L'étude utilisée pour les captures de cette page : une EMA 50, mesurée à 3, 6 et 40 barres en unités ATR, sans TP ni SL.La vue de la même étude : la courbe de l'EMA et le style des marqueurs long et short.
Éviter de lire le futur
Une bougie ne peut utiliser que son passé. Une fenêtre centrée ou un shift(-1) introduit le futur sans que cela se voie dans le résultat. Pour les données d'une unité de temps supérieure, ctx.causal_feature(...) aligne chaque valeur sur la dernière bougie source clôturée. Les colonnes nommées y_* restent réservées aux labels futurs.
Itérer sans perdre le fil
Une étude peut vivre dans le notebook ou dans un fichier Python rechargé à chaque appel. Seuls le calcul, les paramètres et l'évaluation identifient une variante : changer une couleur ne crée pas un nouvel essai. Les filtres de session et de taille de bougie s'appliquent après l'émission, sans créer de nouveau signal.
02Mesurer contre le hasard
Comparer chaque signal à des entrées tirées au hasard
Un signal connu à la clôture d'une bougie est évalué à partir de l'ouverture suivante. Pour chaque horizon, le mode mesure le rendement dans le sens du signal, l'excursion favorable (MFE), l'excursion défavorable (MAE) et le franchissement de barrières. En unités ATR, l'échelle utilisée est celle connue au moment du signal.
Le même calcul est appliqué à toutes les barres éligibles de la période, avec la même proportion de long et de short. L'écart entre les deux, le lift, est accompagné d'un intervalle de confiance à 95 % obtenu par bootstrap par jour. Chaque ligne reçoit enfin un diagnostic : POSITIVE, NEGATIVE, INCONCLUSIVE ou INSUFFICIENT.
Signal contre entrées aléatoires, sortie du rapport
Sens
Horizon¹
Signaux valides
Moyenne signal
Moyenne hasard
Lift moyen
IC 95 % du lift
Diagnostic
ALL
3
3307
-0.011764
0.001692
-0.013456
[-0.053551 ; 0.032919]
INCONCLUSIVE
LONG
3
1796
0.017760
0.019636
-0.001876
[-0.063809 ; 0.052811]
INCONCLUSIVE
SHORT
3
1511
-0.046856
-0.019636
-0.027220
[-0.091209 ; 0.042453]
INCONCLUSIVE
ALL
6
3307
0.024737
0.003438
0.021300
[-0.045838 ; 0.084326]
INCONCLUSIVE
LONG
6
1796
0.139585
0.039889
0.099697
[0.017798 ; 0.176226]
POSITIVE
SHORT
6
1511
-0.111773
-0.039889
-0.071884
[-0.166403 ; 0.016405]
INCONCLUSIVE
ALL
12
3307
0.054660
0.006886
0.047773
[-0.036672 ; 0.131722]
INCONCLUSIVE
LONG
12
1796
0.193716
0.079905
0.113811
[-0.008983 ; 0.229892]
INCONCLUSIVE
SHORT
12
1511
-0.110625
-0.079905
-0.030720
[-0.160339 ; 0.099989]
INCONCLUSIVE
¹ Horizon en barres. Les valeurs sont reprises telles quelles de research.report().predictive, sans conversion en pourcentage. Le tableau complet, avec ses 25 colonnes, se déplie ci-dessous.
Lecture de cet exemple : seul LONG à 6 barres porte le diagnostic POSITIVE (lift de 0,099697 ; IC 95 % [0,017798 ; 0,176225]). Les huit autres lignes sont INCONCLUSIVE. Ce résultat décrit le signal évalué, sans établir la rentabilité d’une stratégie après gestion et coûts.
Tableau complet · 25 colonnes
research.report().predictive
direction
horizon
signals
valid
coverage
signal_days
mean_r
mean_r_ci_low
mean_r_ci_high
median_r
positive_rate
positive_rate_ci_low
positive_rate_ci_high
random_bars
random_mean_r
random_positive_rate
lift_mean_r
lift_mean_r_ci_low
lift_mean_r_ci_high
lift_positive_pp
lift_positive_pp_ci_low
lift_positive_pp_ci_high
p_lift_gt_zero
standardized_lift
edge_status
ALL
3
3307
3307
1.0
1490
-0.011764
-0.051966
0.034240
-0.032845
0.485637
0.470462
0.501240
139945
0.001692
0.500209
-0.013456
-0.053551
0.032919
-1.457246
-2.987382
0.125400
0.26875
-0.009910
INCONCLUSIVE
LONG
3
1796
1796
1.0
1203
0.017760
-0.042043
0.075393
-0.003113
0.497216
0.474803
0.520619
139945
0.019636
0.509472
-0.001876
-0.063809
0.052811
-1.225554
-3.533868
1.077078
0.47375
-0.001415
INCONCLUSIVE
SHORT
3
1511
1511
1.0
1088
-0.046856
-0.113508
0.025539
-0.068482
0.471873
0.448815
0.495764
139945
-0.019636
0.489199
-0.027220
-0.091209
0.042453
-1.732640
-3.972199
0.541348
0.19875
-0.019526
INCONCLUSIVE
ALL
6
3307
3307
1.0
1490
0.024737
-0.042258
0.087761
0.037933
0.508920
0.492876
0.525071
139942
0.003438
0.500694
0.021300
-0.045838
0.084326
0.822662
-0.794802
2.427798
0.74250
0.011365
INCONCLUSIVE
LONG
6
1796
1796
1.0
1203
0.139585
0.051836
0.220225
0.115918
0.531180
0.507071
0.552943
139942
0.039889
0.512484
0.099697
0.017798
0.176226
1.869666
-0.364433
3.946814
0.99500
0.055145
POSITIVE
SHORT
6
1511
1511
1.0
1088
-0.111773
-0.206676
-0.017164
-0.073033
0.482462
0.458492
0.507810
139942
-0.039889
0.486680
-0.071884
-0.166403
0.016405
-0.421825
-2.804725
1.961648
0.07000
-0.037034
INCONCLUSIVE
ALL
12
3307
3307
1.0
1490
0.054660
-0.029237
0.140344
0.056953
0.511037
0.495103
0.527579
139936
0.006886
0.501116
0.047773
-0.036672
0.131722
0.992072
-0.614970
2.654518
0.87000
0.018348
INCONCLUSIVE
LONG
12
1796
1796
1.0
1203
0.193716
0.070280
0.313809
0.190792
0.535635
0.513033
0.559339
139936
0.079905
0.515607
0.113811
-0.008983
0.229892
2.002761
-0.180988
4.093067
0.96625
0.043656
INCONCLUSIVE
SHORT
12
1511
1511
1.0
1088
-0.110625
-0.252657
0.024479
-0.089458
0.481800
0.454480
0.508412
139936
-0.079905
0.483893
-0.030720
-0.160339
0.099989
-0.209250
-2.633276
2.359780
0.33500
-0.011859
INCONCLUSIVE
Dans cet exemple, seul le sens LONG à 6 barres obtient un diagnostic POSITIVE (lift de 0,0997, intervalle à 95 % de 0,0178 à 0,1762). Les huit autres lignes restent INCONCLUSIVE. Le résultat porte sur le signal seul : il ne dit encore rien de la rentabilité d'une stratégie après gestion et frais.
03Comparer les versions
Retrouver à chaque modification la version précédente et la référence
Chaque run est enregistré puis comparé automatiquement à la dernière version distincte et à la référence de la série, c'est-à-dire le premier run enregistré tant qu'elle n'est pas déplacée. L'utilisateur voit ainsi immédiatement si sa modification améliore le signal, et s'il s'éloigne de son point de départ.
research.run(ema_signal, params={"ema_span": 30})   # A : la référence
research.run(ema_signal, params={"ema_span": 40})   # B
research.run(ema_signal, params={"ema_span": 50})   # C
report = research.report()
report.comparisons["previous"]   # C contre B
report.comparisons["baseline"]   # C contre A
Trois versions du même indicateur dans une même série.
Le rapport indique quels signaux sont conservés, ajoutés ou retirés, et comment les mesures évoluent. Un changement de données, de période ou d'évaluation ouvre une nouvelle série, afin de ne jamais comparer des expériences différentes.
L'historique est conservé dans une base SQLite, accompagnée d'un journal Markdown lisible : les rapports restent consultables après un redémarrage. Renommer un notebook conserve son historique ; le copier crée une nouvelle identité qui garde la trace de sa filiation.
04Juger le timing
Reconnaître une entrée plus précoce ou plus tardive sur le même mouvement
Lorsqu'une modification avance une entrée de trois bougies, une comparaison classique voit un signal supprimé et un autre ajouté. Le juge de timing rattache plutôt chaque signal au mouvement de prix auquel il appartient, puis compare les deux versions mouvement par mouvement. Chaque entrée reçoit l'une des quatre catégories suivantes :
01Anticipée
L'entrée précède un mouvement de même sens, dans la fenêtre autorisée.
02Dans le mouvement
L'entrée appartient au mouvement, et sa position y est mesurée.
03Tardive
Une trop grande part du mouvement est déjà consommée, ou un repli important a déjà eu lieu.
04Hors mouvement
Aucun mouvement compatible n'est trouvé.
research.set_movement_judge(MovementJudge())
research.run(study, params=params)
m = research.report().comparisons["previous"].movements
m.summary, m.transitions, m.worst(15)
Le rapport fait ressortir les changements de timing et les mouvements qui méritent d'être inspectés.
05Inspecter et rejouer
Un graphique relié au notebook, et un replay qui masque le futur
research.serve(run) ouvre un serveur local qui affiche le résultat déjà calculé : consulter le graphique ne relance pas l'étude.
Une étude en développement (split DEV). Chaque cas actif se parcourt avec précédent et suivant, puis s'ouvre dans le notebook avec le contexte choisi : ici 10 barres avant et 10 barres après.
Du graphique vers le notebook
Le graphique permet de :
sélectionner des zones et les envoyer au notebook, qui met à jour research.query ;
ouvrir le contexte complet d'un signal avec « Inspect in notebook » ;
recevoir dans la page les filtres appliqués depuis le notebook.
Une sélection manuelle de zones est signalée comme discrétionnaire.
Rejouer sans voir la suite
Le replay simple démarre en pause, masque la bougie choisie et tout ce qui suit, puis avance signal par signal ou bougie par bougie. Les flèches permettent de naviguer et la barre d'espace lance ou suspend la lecture.
Modifier un paramètre depuis le panneau Paramètres crée une nouvelle variante en DEV. Cet éditeur est verrouillé en OOS.
06Entraîner l'œil
Mesurer une intuition avec des campagnes à l'aveugle
Un trader discrétionnaire peut avoir le sentiment de savoir reconnaître les bons signaux. Les campagnes permettent de le vérifier : un humain ou un modèle trie des signaux (Prendre ou Rejeter) sans voir la suite, puis sa sélection est comparée à des sélections aléatoires parmi les mêmes candidats.
Quatre façons de décider sont distinguées : discrétionnaire sans assistance, discrétionnaire aidé par les valeurs connues au moment du signal, filtre quantitatif et annotation rétrospective. Une annotation faite en voyant le futur n'est jamais mélangée aux résultats à l'aveugle.
Le panneau de campagne : mode de décision, buckets Prendre et Rejeter avec leurs touches, règle de validation par défaut (SL d'une ATR, seuil favorable de deux ATR, horizon de 24 barres) et taille de chaque phase.
01Mesure initiale
Des décisions à l'aveugle pour établir le point de départ.
02Apprentissage exploratoire
Le résultat est montré après chaque décision, dans l'ordre chronologique.
03Entraînement stabilisé
Au moins deux blocs, pour séparer entraînement et validation.
04Évaluation finale
À l'aveugle, sur des observations jamais vues.
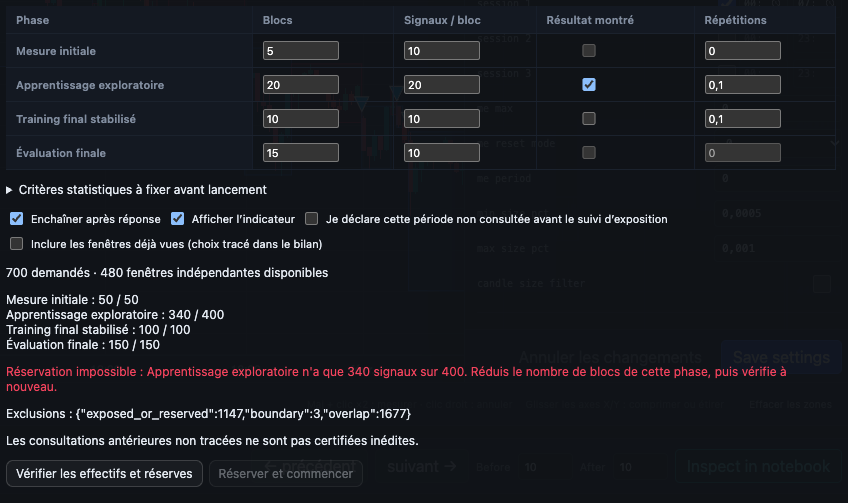
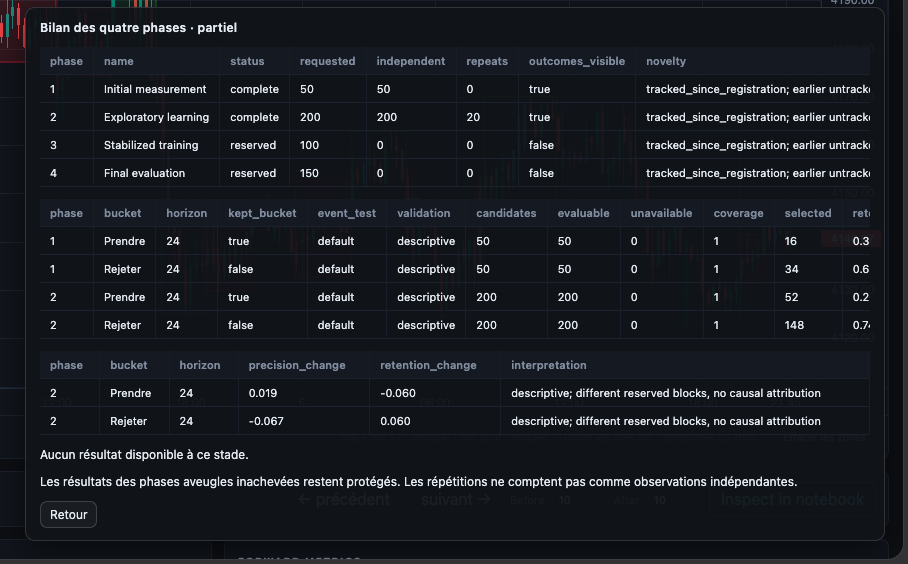
Avant le lancement, le panneau vérifie les effectifs. Ici, la phase d'apprentissage demande 400 signaux alors que 340 seulement restent inédits : la réservation est refusée plutôt que réduite en silence.Bilan partiel d'une campagne : les phases 1 et 2 sont terminées, les phases 3 et 4 restent réservées et leurs résultats protégés.
Chaque fenêtre affichée est enregistrée par date, actif et unité de temps. Le replay libre compte aussi : renommer des signaux ne rend pas une fenêtre « jamais vue ». L'export vers le machine learning exclut les phases 1 et 2, et le modèle est figé avant la phase finale.
07Figer et tester ailleurs
Figer la configuration avant d'ouvrir l'échantillon réservé
La séparation entre développement (DEV) et hors échantillon (OOS) se déclare dès la création de Research. Le freeze enregistre la configuration et les conclusions avant tout accès à la partie réservée, et le contrôle s'exécute avant le calcul OOS. Les barres antérieures peuvent servir à initialiser les indicateurs, mais seules les observations autorisées sont publiées.
Le parcours après création de l'étude : développement, freeze, hors échantillon, puis un autre actif avec les mêmes paramètres.
Les essais sont comptés dans le même registre de validation que le mode Algo : une nouvelle décision compte, un run identique est reconnu, et regarder ou zoomer reste une simple observation. Le test sur un autre actif ne crée pas de nouvel essai, mais chaque lancement est enregistré pour que les répétitions restent visibles.
08Passer au mode Algo
Du signal mesuré à la stratégie exécutée
Research · le signal
Calculer l'indicateur, mesurer ce qui suit ses signaux, comparer les versions.
→
Algo · la stratégie
Choisir les entrées, gérer les positions, appliquer les frais et le sizing.
En commun : le graphique, le serveur local, le manifeste de freeze et le registre des essais.
Passer au mode Algo consiste à formaliser les entrées en setups, puis à ajouter la gestion des positions, les frais et le sizing. Les conclusions de Research doivent alors être vérifiées à nouveau : un signal qui précède bien les mouvements ne garantit pas une stratégie rentable.
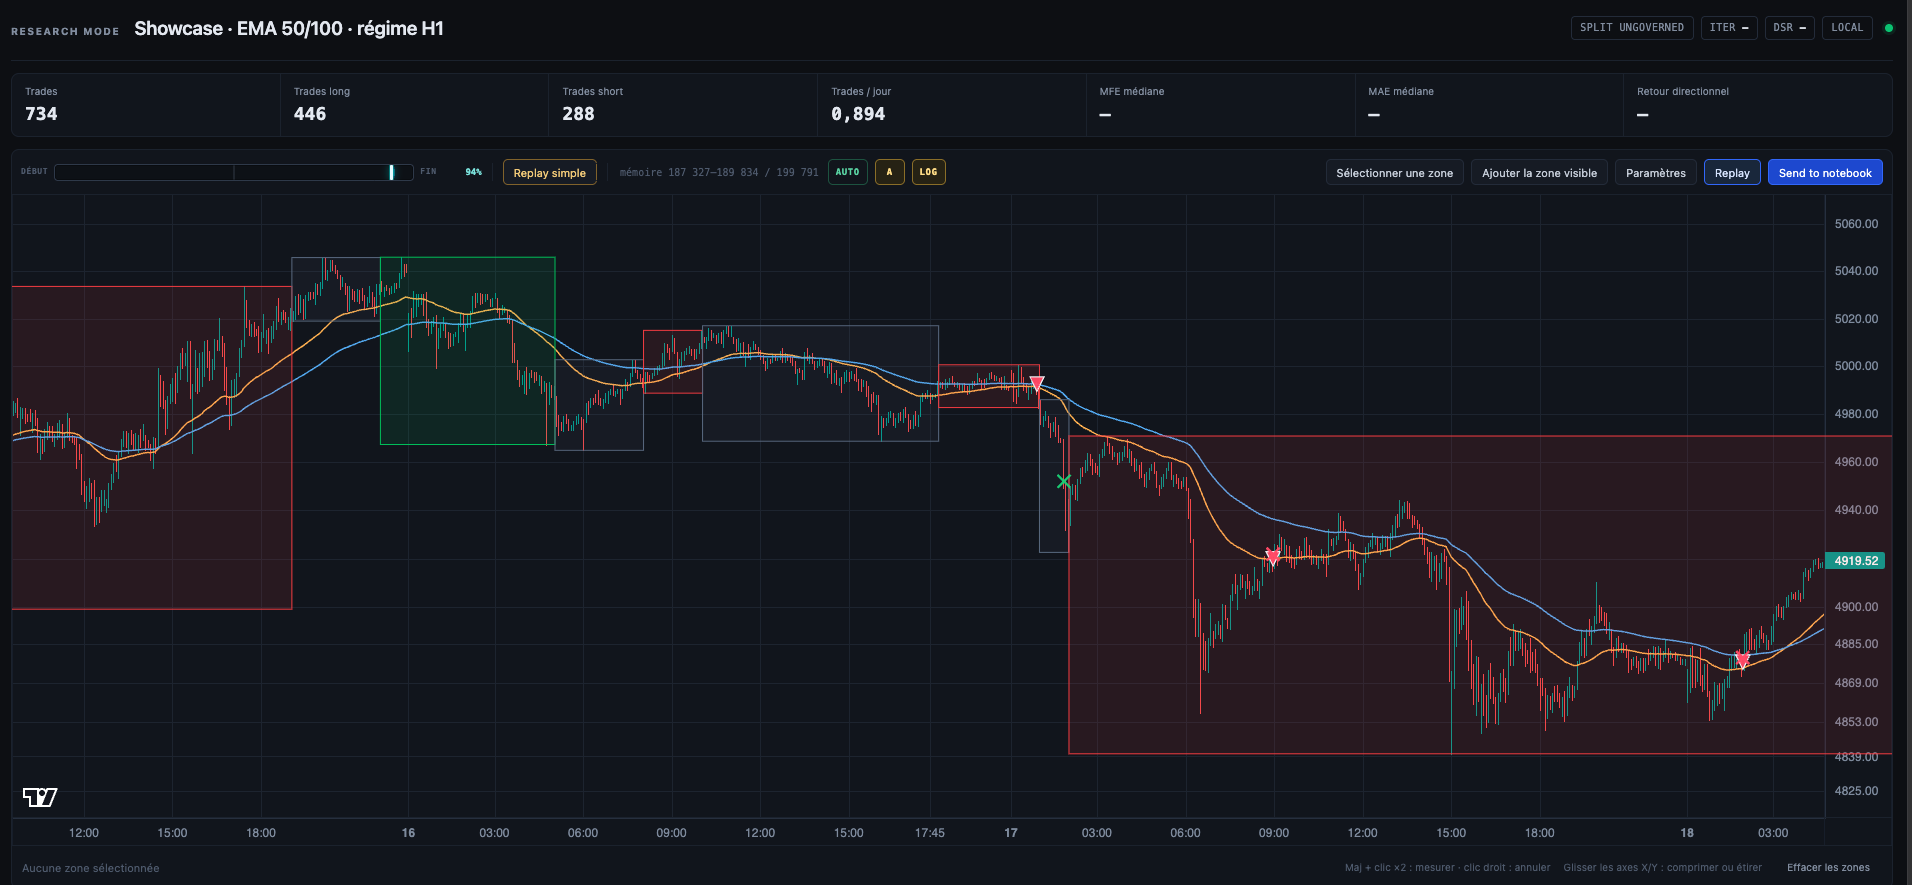
Le même serveur affiche ici un backtest du mode Algo : croisement EMA 50/100 avec régime H1, 734 trades. Les zones colorées sont les régimes, les triangles les entrées et les croix les sorties.
Dans l'autre sens, @engine.research_view déclare un graphique avant le run : les bougies, les entrées et les sorties du moteur y sont ajoutées automatiquement, et engine.bind_research_view(study) peut réutiliser la vue d'une étude. Le résultat s'ouvre en lecture seule : rien n'est recalculé, aucun essai n'est compté et le freeze n'est pas modifié.
Backtest engineResearch mode · October 2026
Research mode, developing an indicator and measuring its signals
Research mode lets you test an entry idea before turning it into a strategy. The user writes the indicator in a few lines; the mode measures what actually happens after each signal, compares it with randomly drawn entries and with the previous version, then shows the result on a chart linked to the notebook.
At this stage no trade management, no costs and no compilation are needed. The aim is to find out quickly whether the signal is worth developing in Algo mode.
0compilations to test a new variant
2automatic comparisons on every run: previous version and baseline
25measures per horizon and direction, against chance
4phases to train the eye blind
Preview
The study. Left, an EMA 50: its signals and what is measured afterwards (horizons of 3, 6 and 40 bars, in ATR units). Right, the chart declaration. Click a screenshot to enlarge it.
The chart. The result of that study in the local server: long and short signals on gold, the EMA 50 and, at the top, the report's measures (median MFE, MAE and return at 40 bars, in ATR).
The cases. On another study in development, each signal can be stepped through one at a time and opened in the notebook. Top right, ITER and DSR show how many trials have already been counted.
Training. Setting up a blind replay campaign: four phases, reserved windows and criteria fixed before launch.
01Write a study
Declaring an indicator, its signals and what you want to measure
A study is a Python function that receives prices, computes its columns and returns long and short signals. Three declarations come with it, so that every choice stays explicit:
SignalSpec states how a signal becomes an event: on the first candle of a run (rising_edge) or on every candle (every_true_bar), with an optional cooldown;
ForwardEvaluationSpec sets what is measured next: entry point, horizons and unit;
the view chooses the curves, markers and panes shown on the chart.
The study used for the screenshots on this page: an EMA 50, measured at 3, 6 and 40 bars in ATR units, with no TP or SL.The view of the same study: the EMA line and the style of the long and short markers.
Not reading the future
A candle may only use its past. A centred window or a shift(-1) brings in the future without it showing in the result. For higher-timeframe data, ctx.causal_feature(...) aligns each value to the last closed source candle. Columns named y_* stay reserved for future labels.
Iterating without losing track
A study can live in the notebook or in a Python file reloaded on each call. Only the calculation, the parameters and the evaluation identify a variant: changing a colour does not create a new trial. Session and candle-size filters apply after emission, without creating a new signal.
02Measure against chance
Comparing each signal with randomly drawn entries
A signal known at the close of a candle is evaluated from the next open. For each horizon, the mode measures the return in the signal's direction, the favourable excursion (MFE), the adverse excursion (MAE) and barrier touches. In ATR units, the scale is the one known at the signal.
The same calculation is applied to every eligible bar in the period, with the same share of longs and shorts. The gap between the two, the lift, comes with a 95% confidence interval bootstrapped by day. Each row then receives a diagnosis: POSITIVE, NEGATIVE, INCONCLUSIVE or INSUFFICIENT.
Signal against random entries, report output
Direction
Horizon¹
Valid signals
Signal mean
Random mean
Mean lift
Lift 95% CI
Diagnosis
ALL
3
3307
-0.011764
0.001692
-0.013456
[-0.053551 ; 0.032919]
INCONCLUSIVE
LONG
3
1796
0.017760
0.019636
-0.001876
[-0.063809 ; 0.052811]
INCONCLUSIVE
SHORT
3
1511
-0.046856
-0.019636
-0.027220
[-0.091209 ; 0.042453]
INCONCLUSIVE
ALL
6
3307
0.024737
0.003438
0.021300
[-0.045838 ; 0.084326]
INCONCLUSIVE
LONG
6
1796
0.139585
0.039889
0.099697
[0.017798 ; 0.176226]
POSITIVE
SHORT
6
1511
-0.111773
-0.039889
-0.071884
[-0.166403 ; 0.016405]
INCONCLUSIVE
ALL
12
3307
0.054660
0.006886
0.047773
[-0.036672 ; 0.131722]
INCONCLUSIVE
LONG
12
1796
0.193716
0.079905
0.113811
[-0.008983 ; 0.229892]
INCONCLUSIVE
SHORT
12
1511
-0.110625
-0.079905
-0.030720
[-0.160339 ; 0.099989]
INCONCLUSIVE
¹ Horizon in bars. Values are taken as they are from research.report().predictive, with no conversion to percentages. The full table, with its 25 columns, unfolds below.
Reading this example: only LONG at 6 bars is labelled POSITIVE (lift 0.099697; 95% CI [0.017798; 0.176225]). The other eight rows are INCONCLUSIVE. This describes the evaluated signal, without establishing strategy profitability after management and costs.
Full table · 25 columns
research.report().predictive
direction
horizon
signals
valid
coverage
signal_days
mean_r
mean_r_ci_low
mean_r_ci_high
median_r
positive_rate
positive_rate_ci_low
positive_rate_ci_high
random_bars
random_mean_r
random_positive_rate
lift_mean_r
lift_mean_r_ci_low
lift_mean_r_ci_high
lift_positive_pp
lift_positive_pp_ci_low
lift_positive_pp_ci_high
p_lift_gt_zero
standardized_lift
edge_status
ALL
3
3307
3307
1.0
1490
-0.011764
-0.051966
0.034240
-0.032845
0.485637
0.470462
0.501240
139945
0.001692
0.500209
-0.013456
-0.053551
0.032919
-1.457246
-2.987382
0.125400
0.26875
-0.009910
INCONCLUSIVE
LONG
3
1796
1796
1.0
1203
0.017760
-0.042043
0.075393
-0.003113
0.497216
0.474803
0.520619
139945
0.019636
0.509472
-0.001876
-0.063809
0.052811
-1.225554
-3.533868
1.077078
0.47375
-0.001415
INCONCLUSIVE
SHORT
3
1511
1511
1.0
1088
-0.046856
-0.113508
0.025539
-0.068482
0.471873
0.448815
0.495764
139945
-0.019636
0.489199
-0.027220
-0.091209
0.042453
-1.732640
-3.972199
0.541348
0.19875
-0.019526
INCONCLUSIVE
ALL
6
3307
3307
1.0
1490
0.024737
-0.042258
0.087761
0.037933
0.508920
0.492876
0.525071
139942
0.003438
0.500694
0.021300
-0.045838
0.084326
0.822662
-0.794802
2.427798
0.74250
0.011365
INCONCLUSIVE
LONG
6
1796
1796
1.0
1203
0.139585
0.051836
0.220225
0.115918
0.531180
0.507071
0.552943
139942
0.039889
0.512484
0.099697
0.017798
0.176226
1.869666
-0.364433
3.946814
0.99500
0.055145
POSITIVE
SHORT
6
1511
1511
1.0
1088
-0.111773
-0.206676
-0.017164
-0.073033
0.482462
0.458492
0.507810
139942
-0.039889
0.486680
-0.071884
-0.166403
0.016405
-0.421825
-2.804725
1.961648
0.07000
-0.037034
INCONCLUSIVE
ALL
12
3307
3307
1.0
1490
0.054660
-0.029237
0.140344
0.056953
0.511037
0.495103
0.527579
139936
0.006886
0.501116
0.047773
-0.036672
0.131722
0.992072
-0.614970
2.654518
0.87000
0.018348
INCONCLUSIVE
LONG
12
1796
1796
1.0
1203
0.193716
0.070280
0.313809
0.190792
0.535635
0.513033
0.559339
139936
0.079905
0.515607
0.113811
-0.008983
0.229892
2.002761
-0.180988
4.093067
0.96625
0.043656
INCONCLUSIVE
SHORT
12
1511
1511
1.0
1088
-0.110625
-0.252657
0.024479
-0.089458
0.481800
0.454480
0.508412
139936
-0.079905
0.483893
-0.030720
-0.160339
0.099989
-0.209250
-2.633276
2.359780
0.33500
-0.011859
INCONCLUSIVE
In this example, only LONG at 6 bars is diagnosed POSITIVE (lift 0.0997, 95% interval from 0.0178 to 0.1762). The other eight rows remain INCONCLUSIVE. The result concerns the signal alone: it says nothing yet about the profitability of a strategy after management and costs.
03Compare versions
Finding the previous version and the baseline after every change
Every run is recorded and automatically compared with the last distinct version and with the series baseline, that is the first recorded run until it is moved. The user can see straight away whether a change improves the signal, and whether it drifts from the starting point.
research.run(ema_signal, params={"ema_span": 30})   # A: the baseline
research.run(ema_signal, params={"ema_span": 40})   # B
research.run(ema_signal, params={"ema_span": 50})   # C
report = research.report()
report.comparisons["previous"]   # C against B
report.comparisons["baseline"]   # C against A
Three versions of the same indicator in one series.
The report shows which signals are kept, added or removed, and how the measures move. Changing the data, the period or the evaluation opens a new series, so different experiments are never compared.
History is stored in a SQLite database with a readable Markdown journal: reports remain available after a restart. Renaming a notebook keeps its history; copying it creates a new identity that records its lineage.
04Judge timing
Recognising an earlier or later entry on the same move
When a change brings an entry forward by three candles, a plain comparison sees one signal removed and another added. The timing judge instead attaches each signal to the price move it belongs to, then compares the two versions move by move. Each entry falls into one of four categories:
01Early
The entry precedes a move in the same direction, within the allowed window.
02Within the move
The entry belongs to the move, and its position in it is measured.
03Late
Too much of the move is already used up, or a large pullback has already happened.
04Outside a move
No compatible move is found.
research.set_movement_judge(MovementJudge())
research.run(study, params=params)
m = research.report().comparisons["previous"].movements
m.summary, m.transitions, m.worst(15)
The report highlights timing changes and the moves worth inspecting.
05Inspect and replay
A chart linked to the notebook, and a replay that hides the future
research.serve(run) opens a local server that displays the result already computed: looking at the chart does not rerun the study.
A study in development (DEV split). Each active case can be stepped through with previous and next, then opened in the notebook with the chosen context: here 10 bars before and 10 bars after.
From the chart to the notebook
The chart lets you:
select zones and send them to the notebook, which updates research.query;
open the full context of a signal with “Inspect in notebook”;
receive in the page the filters applied from the notebook.
A manual zone selection is flagged as discretionary.
Replaying without seeing what comes next
Simple replay starts paused, hides the chosen candle and everything after it, then advances signal by signal or candle by candle. Arrow keys navigate and the space bar plays or pauses.
Changing a parameter from the Settings panel creates a new variant in DEV. That editor is locked in OOS.
06Train the eye
Measuring an intuition with blind campaigns
A discretionary trader may feel able to recognise good signals. Campaigns make it possible to check: a human or a model sorts signals (Take or Reject) without seeing what follows, then the selection is compared with random selections from the same candidates.
Four ways of deciding are kept apart: unassisted discretion, discretion aided by values known at the signal, quantitative filter and retrospective annotation. An annotation made while seeing the future is never mixed with blind results.
The campaign panel: decision mode, Take and Reject buckets with their keys, default validation rule (SL of one ATR, favourable threshold of two ATR, 24-bar horizon) and the size of each phase.
01Initial measurement
Blind decisions to set the starting point.
02Exploratory learning
The outcome is shown after each decision, in chronological order.
03Stabilised training
At least two blocks, to separate training from validation.
04Final evaluation
Blind, on observations never seen.
Before launch, the panel checks sample sizes. Here the learning phase asks for 400 signals while only 340 remain unseen: the reservation is refused rather than silently reduced.Partial report of a campaign: phases 1 and 2 are complete, phases 3 and 4 remain reserved and their results protected.
Every window shown is logged by date, asset and timeframe. Free replay counts too: renaming signals does not make a window “never seen”. The machine-learning export excludes phases 1 and 2, and the model is frozen before the final phase.
07Freeze and test elsewhere
Freezing the configuration before opening the reserved sample
The split between development (DEV) and out of sample (OOS) is declared when Research is created. The freeze records the configuration and the conclusions before any access to the reserved part, and the check runs before the OOS calculation. Earlier bars can warm up the indicators, but only authorised observations are published.
The workflow once the study exists: development, freeze, out of sample, then another asset with the same parameters.
Trials are counted in the same validation registry as Algo mode: a new decision counts, an identical run is recognised, and looking or zooming remains a plain observation. Testing on another asset does not create a new trial, but each launch is recorded so repetitions stay visible.
08Move into Algo mode
From a measured signal to an executed strategy
Research · the signal
Compute the indicator, measure what follows its signals, compare versions.
→
Algo · the strategy
Choose entries, manage positions, apply costs and sizing.
Shared: the chart, the local server, the freeze manifest and the trial registry.
Moving into Algo mode means turning entries into setups, then adding position management, costs and sizing. Research's conclusions then have to be checked again: a signal that anticipates moves well does not guarantee a profitable strategy.
The same server here shows an Algo mode backtest: EMA 50/100 crossover with an H1 regime, 734 trades. Coloured zones are regimes, triangles are entries and crosses are exits.
In the other direction, @engine.research_view declares a chart before the run: the engine's candles, entries and exits are added automatically, and engine.bind_research_view(study) can reuse a study's view. The result opens read-only: nothing is recomputed, no trial is counted and the freeze is untouched.