Rendre un kernel compilé capable de décisions stateful
L'ambition du moteur est d'accueillir toutes les stratégies, y compris celles dont la décision dépend d'un état accumulé, sans que l'utilisateur traduise sa logique. Dans un moteur hybride Python/Numba, appeler à chaque barre la fonction Python utilisateur où cette logique est écrite serait trop lourd. Le replay, le resume et le watcher préservent cette liberté sans payer ce coût.
Le problème
L'information dont la décision a besoin n'existe qu'après le run
Exemple concret. Une règle de sortie veut réduire une position quand le P&L latent du trade dépasse deux fois le risque initial, et veut aussi savoir combien de stops ont été touchés depuis l'ouverture de la journée. Ces deux quantités ne sont pas dans les données de marché. Elles n'existent qu'une fois le portefeuille simulé.
Dans un moteur écrit en Python, un callback est appelé à chaque barre. Le coût est prohibitif : la boucle quitte le code machine des millions de fois, et la simulation devient plus lente que la recherche qu'elle est censée servir. Dans un kernel compilé, ce callback n'existe pas.
La réponse évidente serait de compiler la fonction de décision elle-même. Elle est écartée, et c'est le choix qui structure tout le reste. La fonction de décision est l'endroit où l'utilisateur écrit sa stratégie : l'y contraindre à un sous-ensemble compilable du langage reviendrait à lui interdire pandas, un optimiseur, un modèle entraîné, une bibliothèque tierce, tout ce qu'il pourrait vouloir appeler. Le moteur cesserait alors de servir son but, qui est de laisser l'utilisateur écrire sa logique et rien d'autre.
La contrainte se referme donc des deux côtés. La décision doit rester du Python ordinaire, et la boucle ne doit pas l'appeler à chaque barre. Les trois mécanismes qui suivent sont des façons de tenir les deux à la fois.
Mode 1
Replay : le run précédent devient une donnée d'entrée
Le run 1 s'exécute à pleine vitesse et publie son état complet : le P&L latent barre par barre, l'historique de chaque trade, les événements d'ordres, les expositions. Une fonction Python lit cet état et renvoie un patch. Le run 2 repart de la première barre avec ce patch déjà en mémoire. Le kernel n'a jamais appelé Python pendant la boucle.
Ce que le patch peut contenir
- Portée globale. Des séries alignées sur les barres, indépendantes du P&L latent d'un trade en particulier : un filtre de régime, un plafond d'exposition, une mise à plat forcée.
- Portée locale. Des actions rattachées à un trade précis :
SET_TP,SET_SL,MOVE_SL_TO_BE,PARTIAL_EXIT,ADD_WEIGHT,FORCE_EXIT. C'est là que se développent les stratégies de sortie adaptatives, celles qui dépendent de la trajectoire du trade et non du signal d'entrée.
Le patch est compilé en tableaux avant le run 2, et le run 2 publie à son tour son état, qui peut alimenter un replay 2, puis un replay 3.
Le prix à payer est explicite. Le patch est construit en connaissant l'intégralité du run précédent, donc son futur. Chaque itération est un ajustement rétrospectif, et l'empilement des itérations est une machine à surapprentissage.
La discipline associée est simple : le replay est un atelier, pas un résultat. Une règle trouvée en replay doit ensuite être rejouée en causal, sans connaissance du futur, avant d'être considérée comme une stratégie.
Ce que le moteur garantit, et ce qu'il ne garantit pas. Tout signal construit sur
l'OHLCV porte un délai par défaut d'une barre, et le moteur refuse toute configuration qui
descendrait en dessous : entry_delay vaut 1, et une valeur nulle est rejetée
à la construction comme un biais de look-ahead. Les actions de replay et les décisions de
watcher portent le même délai d'une barre par défaut. En revanche, le moteur ne peut pas
savoir ce que la fonction de replay ira chercher dans l'état qui lui est remis. C'est à
l'utilisateur de ne pas y puiser du futur. La fuite de données ne vient pas de la
mécanique du moteur, elle vient de ce que l'utilisateur écrit dans la fonction.
Mode 2
Resume : le run s'arrête vraiment, et l'état traverse la frontière
Pour une politique d'action continue, le rétrospectif ne suffit pas. Il faut décider dans le run, avec la seule information disponible à cet instant. Le mode resume arrête réellement l'exécution. À chaque frontière déclarée, le kernel rend la main, une fonction utilisateur est appelée, puis le kernel reprend avec l'état du portefeuille intact.
Deux usages
- Sizing. À chaque ouverture de trade, la fonction décide du montant à risquer. Elle peut s'appuyer sur les événements capturés dans un run précédent.
- Allocation. À chaque période, la fonction décide des poids et des actifs retenus pour la période suivante.
Le coût du sizing est assumé et connu d'avance : si la décision doit être prise à chaque ouverture, la fonction utilisateur sera appelée autant de fois qu'il y a de trades. Il n'y a pas d'échappatoire sans renoncer à décider trade par trade. Ce qui est évitable, en revanche, c'est de payer un appel par barre, et c'est précisément ce que la frontière déclarée supprime.
Pourquoi laisser la porte ouverte à Python
La fonction de décision peut être compilée en Numba et bridgée au kernel. Elle peut aussi rester en Python pur, et c'est souvent le bon choix pendant la phase de recherche : changer une politique en Python coûte une seconde, alors que recompiler le kernel coûte plusieurs minutes. Le compromis se choisit au cas par cas, sans changer l'architecture.
Mode 3
Watcher : séparer la détection, qui est légère, de la décision, qui est lourde
Reste un cas gênant. Une politique qui veut réagir à un événement précis, mais dont la réaction est coûteuse, ne peut pas se contenter d'un rendez-vous périodique : l'événement tombe entre deux rendez-vous et la réaction arrive en retard. Le watcher résout cela en coupant le problème en deux.
- La détection est une petite fonction Numba écrite par l'utilisateur, scannée barre par barre à l'intérieur du kernel. Elle ne manipule que des scalaires : drawdown courant, durée sous les eaux, volatilité, bêta, exposition brute et nette, concentration. Son coût est négligeable.
- La décision est la fonction Python lourde. Elle n'est appelée que lorsque la détection se déclenche.
Le principe directeur n'est pas de rendre l'appel rapide, il est d'en réduire le nombre. Même compilée, une fonction appelée à chaque barre reste une fonction appelée à chaque barre. Le watcher est donc convoqué à sa fréquence déclarée, et à chaque convocation il examine la période écoulée depuis la précédente, puis s'arrête au premier événement qu'il y trouve. Le reste de la fenêtre n'est pas perdu : le run reprend à la barre de décision et la suite de la période est réexaminée ensuite. C'est le meilleur compromis trouvé entre réactivité et coût.
Deux régimes sont assumés et explicites. En mode causal, la décision reste à la barre du contrôle, ce qui est le comportement admissible pour une stratégie. En mode recherche, la décision remonte à l'événement, ce qui est rétrospectif et doit être activé volontairement. Chaque décision est étiquetée dans les journaux du run selon le régime qui l'a produite.
Les garde-fous ne sont pas décoratifs : temporisation par motif, verrou sur signal persistant pour qu'une condition de niveau ne redéclenche pas à chaque barre, plafond d'événements par contrôle, budget de déclenchements sur la durée du run.
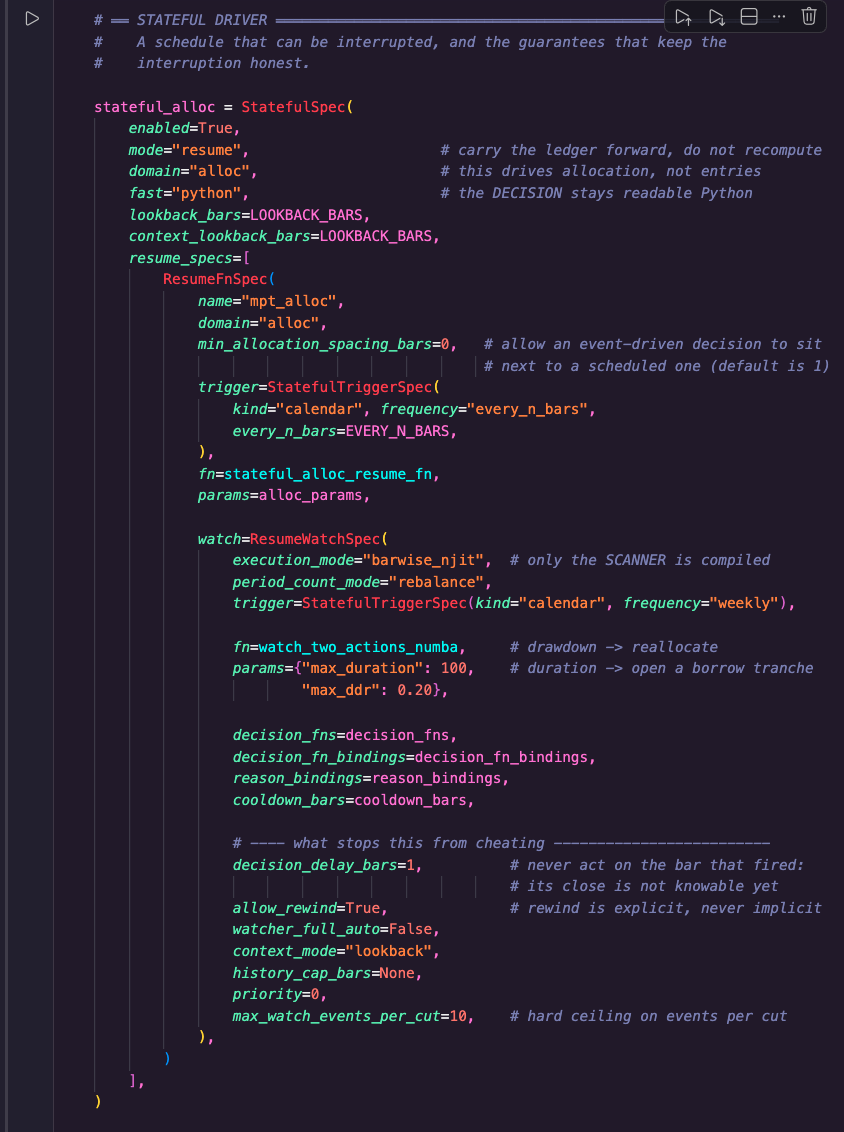
Tout se déclare dans un seul objet : mode choisit le régime,
watch greffe le contrôle par-dessus, et le bloc du bas rassemble les
garanties. Run présenté dans la page Moteur.
Pleine taille
Ce que le contrôle inscrit dans le journal
| Barre de l'événement |
Barre de décision |
Mode | Fonction appelée | Raison | Statut |
|---|---|---|---|---|---|
| 371 | 372 | 3 | borrow_overlay | underwater_duration > 100 | fired |
| 547 | 548 | 2 | mpt_reallocation | current_drawdown ≥ 20 % | fired |
| … | … | ||||
| 1801 | 1802 | 2 | mpt_reallocation | current_drawdown ≥ 20 % | cooldown |
| 1802 | 1803 | 2 | mpt_reallocation | current_drawdown ≥ 20 % | cooldown |
| 1803 | 1804 | 2 | mpt_reallocation | current_drawdown ≥ 20 % | cooldown |
| 1887 | 1888 | 2 | mpt_reallocation | current_drawdown ≥ 20 % | fired |
| 1889 | 1890 | 3 | borrow_overlay | underwater_duration > 100 | fired |
La barre de décision suit toujours celle de l'événement. Jamais la même : la clôture qui a déclenché n'est pas connaissable au moment du signal.
Deux fonctions alternent, chacune avec son mode de déclenchement. Le mode 2 remplace la décision programmée, le mode 3 s'insère à l'intérieur de la période.
Trois cooldown consécutifs, puis un fired. La condition
reste vraie d'une barre à l'autre ; le verrou l'empêche de redéclencher, et il compte par
raison, pas par contrôle.
1 253 lignes sur ce run, huit montrées.
Récapitulatif
Trois régimes, trois usages
| Mode | Quand la décision est prise | Ce qu'elle voit | Coût | Usage |
|---|---|---|---|---|
| Replay | Entre deux runs complets | Tout le run précédent, futur compris | Un run supplémentaire par itération | Concevoir une règle de sortie adaptative |
| Resume | À chaque frontière déclarée, dans le run | Uniquement ce qui précède la coupe | Un appel par frontière, donc un par trade en sizing | Sizing continu, allocation période par période |
| Watcher | À la barre de l'événement, plus le délai | Des scalaires de risque, barre par barre | Un scan par contrôle, un appel lourd par événement | Réagir vite sans payer un appel Python par barre |
Les trois se chaînent. Un replay sert à découvrir la règle et à capturer les événements d'un run, un resume la rejoue en causal, et un watcher lui donne la réactivité sans lui faire perdre la vitesse du kernel.
Dans les trois cas, le décalage d'une barre entre un signal et son exécution est le comportement par défaut et ne peut pas être désactivé. Le reste de la causalité relève de la personne qui écrit la fonction de décision.
Note technique extraite du moteur de backtest multi-stratégies. Les noms de spécifications et d'actions cités correspondent à l'API réelle du moteur.